廣東話語音轉文字若把 Whisper 語言設成「中文」,稿常像普通話近音:講「我哋聽日先 confirm」,畫面變成「我們明天先確認」;講「喺旺角等」,變成「在旺角等」。這不是編碼壞了,是通用模型把粵語口播聽成中文,再用普通話詞彙寫下來。
只把語言設成 zh 或介面裡的「中文」,輸出往往接近書面普通話,而不是可以上 YouTube 的港式字幕。教學文會教你 whisper-cli -l zh,因為這樣比較少崩潰;創作者要的卻是粵語對白,兩者不是同一份工。
讀完你應能分清 zh 與 yue、知道簡轉繁修不了什麼、用三十分鐘對照判斷本機稿能不能出街。訪談、街訪、客服怎麼校對,見 廣東話語音轉文字;這裡只處理「通用 Whisper 為什麼把粵語寫成國語」。
稿讀起來像普通話,通常不是亂碼
亂碼好認:方塊字、重複標點、突然跳英文。真正耗校對時間的,是「每個字都像中文、整句意思卻偏了」。粵語口播經過多語語音模型時,解碼器最穩的文字通道往往是普通話書面語。它不是在翻譯,是在用另一套詞庫猜測同音字。
常見成品長這樣:
- 助詞與介詞被換成國語:口播「喺/嚟/咗」,稿上變成「在/來/了」。
- 判斷句被寫成「是」而不是口語漢字「係」,或更糟,被聽成「市/事」。
- 香港專有名詞被拉去普通話近音:車站、屋苑、連鎖店名變成另一個聽起來差不多的詞。
- 中英夾雜被「中文化」:
deadline、meeting拆成無意義漢字,或整句譯成「截止日期」「會議」。
這類稿用搜尋取代「我們→我哋」救不了。因為錯誤不是繁簡,是語音假設錯了。你改的是書面語風格,模型聽的時候已經當普通話來認。語體轉換應發生在正確的粵語聽寫之後,見 廣東話口語轉書面語。
另一個訊號:同一段錄音,自動語言偵測顯示 zh、概率還很高。Whisper large-v3 雖然把粵語收成獨立代碼 yue,實務上許多粵語音檔仍被標成中文。公開討論裡,使用者即使強制 --language yue,輸出仍可能是書面中文,而不是口語漢字。偵測「成功」只代表模型很有把握這是中文語音,不代表它聽得懂九聲和懶音。
Whisper 的 zh 與 yue 不是同一件事
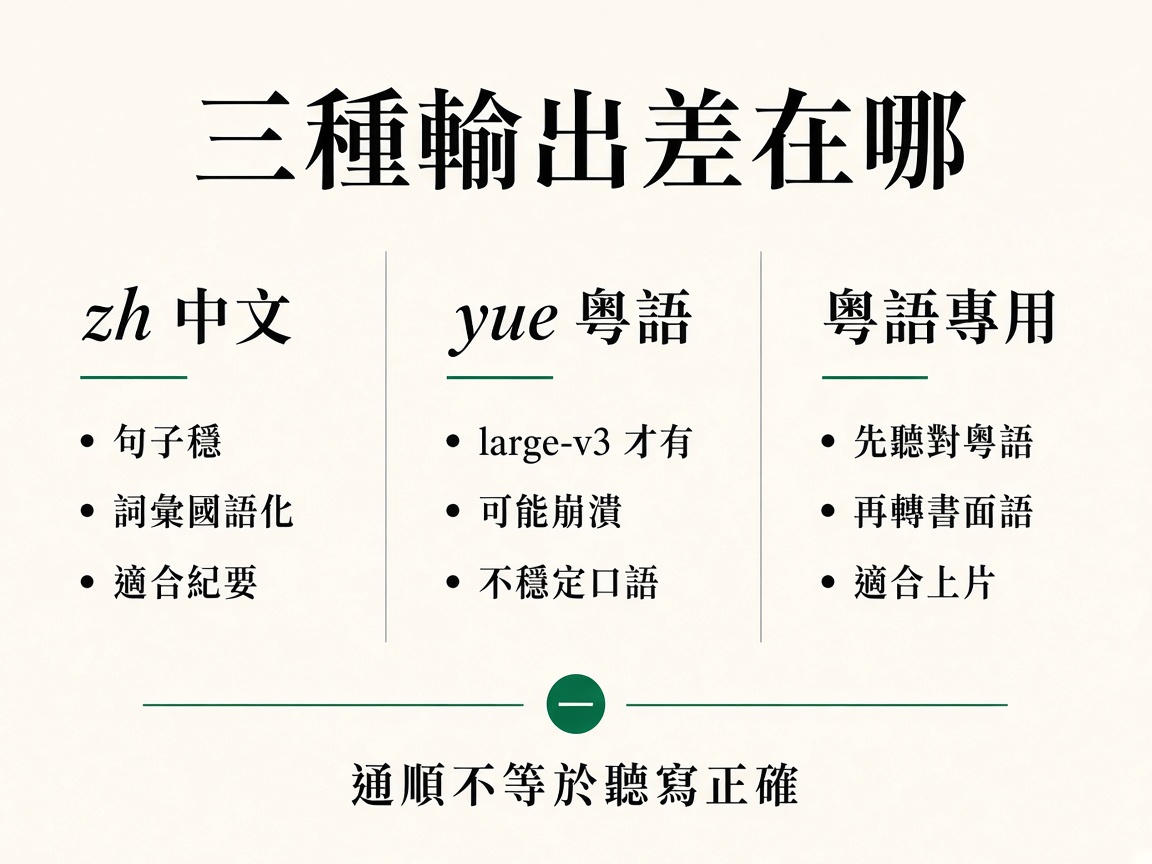
OpenAI Whisper 在 large-v3 才為粵語加了語言代碼 yue(介面也接受 Cantonese)。更早的 large-v2、medium、small 沒有這個 token。你在舊模型寫 language="yue",原版 Whisper 會直接報錯;部分 faster-whisper 封裝則可能靜默當作已設定,實際詞表仍是中文通道。
因此下載頁寫「支援 100 種語言、包括 Cantonese」,要先問三句:
- 模型版本是不是 large-v3 或之後? 只有這一代詞表才有
yue。 - 你有沒有強制語言,還是讓它自動偵測? 自動偵測常回
zh。 - 你要的產出是逐字口語、港式書面語,還是只要「看得懂的中文紀要」? 三種對語言代碼的容忍度完全不同。
強制 zh 的典型結果:句子穩、標點齊、可搜尋,但詞彙國語化。對會議紀要「先有一份能掃的稿」有時夠用;對上片字幕不夠,因為觀眾會看到口型是粵語、字是普通話。
強制 yue 的結果更分裂。有人得到較貼口語的漢字;也有人遇到解碼崩潰——單字重複、亂碼、中途跳去英文。這不是你電腦不夠快,而是部分模型版本的粵語 token 訓練量遠少於 zh,解碼器不穩。升級到更大模型不一定修好;同一代裡 yue 不穩,zh 反而通順。
不要把「通順」當成「粵語正確」。通順只說明解碼器走在它最熟的中文軌道上。
先做三十分鐘對照,不要先換更大模型
硬體升級很貴,對照測試接近免費。取你頻道裡一段兩分鐘素材,條件要「像真的上片」:中英夾雜一句、一個人名或店名、一段少於一秒的停頓。不要只用實驗室朗讀。
同一音檔跑三次(或你工具介面裡等價的三次):
- 自動偵測。 記下它回報的語言代碼。
- 強制中文
zh。 - 強制粵語
yue。 若你的模型根本沒有這個選項,這一列直接標「不支援」,不要改用zh假裝測過。
對照時不要打分數,只標四類現象:國語詞彙、專有名詞、英文詞、崩潰/重複。哪一列崩潰,就淘汰哪一列;哪一列只是國語化,就當它是「紀要稿」而不是「字幕母帶」。
較穩的判斷:
- 自動偵測已是
zh,強制zh的稿又滿是「在/的/了/我們」——這份檔只能當索引,不能燒進短片。 - 強制
yue出現重複字或突然英文,不要把崩潰稿拿去叫另一個語言模型「潤飾」。幻覺句經過潤飾會變得更像真的。 - 三次輸出的專有名詞互不一致,代表模型在猜,不代表平均一下就對。人名、品牌應進詞庫或人工鎖,見 字幕自定義詞庫。
對照只服務一個決定:這條片還要不要留在通用 Whisper。若三次都要大改,再換模型 size 通常只是讓國語稿寫得更順。
簡轉繁與繁體提示修不到的錯
創作者常做兩件「事後補救」,都修不了語音假設。
OpenCC 或任何簡轉繁。 它改的是字形:在 仍是 在,不會變成 喺;的 不會變成 嘅;還是 不會變成你口播的 定係。國語詞彙用繁體寫出來,看起來更像「港式」,其實仍是普通話近音。轉繁體可以解決 YouTube 字型與地區觀感,解決不了聽寫語言。
initial prompt 寫一句繁體開場。 Whisper 的提示會把後續用字往提示的詞表推。寫「以下為粵語講解」有時能減少簡體、固定幾個術語,但它不是語言識別開關。提示裡堆專有名詞,對品牌名有幫助;提示裡寫「請用廣東話口語輸出」,模型仍可能繼續走 zh 通道,只是繁體化。
比較有效的提示用法:放入本集一定會出現的英文詞與專名,例如產品型號、商場名、schedule、confirm。目標是減少英文被拆成漢字,而不是幻想一句提示能把普通話解碼器變成粵語引擎。中英夾雜的取捨見 中英夾雜字幕。
若你的工作流是「Whisper 出稿 → 再叫大型語言模型改成粵語」,要分清它在做翻譯還是校對。翻譯會把已經錯的國語近音再意譯一次,錯人名會變得更像另一個人。校對應對着原音,而不是對着一份已經偏掉的中文。
靜音、音樂與口語漢字:通用模型的三種邊角
靜音與過場。 Whisper 類模型在長空白、只有床底音樂的段落,可能寫出與畫面無關的句子。粵語素材若被當成中文,幻覺句也常是普通話書面語,看起來特別「正式」,更容易混進真對白。對照時專看沒人說話的三秒:那裡不該有完整句子。有對白的難段,才值得重聽。
口語漢字還是書面語。 即使 yue 跑得動,輸出也可能是口語逐字,或是不中不英的書面中文。上片前仍要決定語體。語言課、搞笑 Vlog 可能要留「係咪」「咁樣」;教學與品牌片多數要港式書面語。這一步不該交給語音模型順便做。模型負責聽對;你負責定頻道語氣。
把字幕當成會議紀要。 週會用通用 Whisper 出一份可搜的中文稿,可以接受較多國語化,重點改日期、責任人、專名。同一份稿拿去當 YouTube 軟字幕,觀眾會覺得頻道「講粵語、寫國語」。用途變了,語言代碼的結論也要重做。會議場景見 廣東話會議錄音轉文字。
噪音大的街拍,通用模型更傾向抓普通話高頻詞。先分人聲再轉寫,比加大模型更有效,見 廣東話語音轉文字遇噪音。
廣東話語音轉文字何時仍能用本機 Whisper
本機通用模型適合這些情況:私隱要求音檔不能上雲、你只要粗索引、對白接近朗讀、英文為主只夾少量粵語、你願意把專名當搜尋取代表來養。
它不夠用的情況也很具體:要發布的廣東話字幕、中英夾雜是內容本身、要口語轉書面語而不是國語意譯、同一系列每集都要改同一批店名、你已經在 zh/yue 之間來回卻沒有一列能當母帶。
粵語專用流程不是「再跑一次 Whisper 加提示」。它把語音假設設成廣東話,再讓你選擇保留俚語或轉正式書面語、保留或去掉填充詞、以及英文詞要不要留在畫面。詞庫優先採用你鎖死的寫法,比事後把「確認」改回 confirm 便宜。選工具時看什麼,見 廣東話字幕工具怎麼選。
CantoSub 針對廣東話口語與中英夾雜做轉寫,並把口語轉書面語、詞庫與風格控制放在同一條出片路上,而不是先出普通話近音再人手翻回香港用字。能力與匯出格式以 Model 2.0 與 價格 為準;要試自己的音檔可 註冊。
無論用哪一條路,出街前仍要抽查:專有名詞、數字、靜音段有沒有多出來的句子。通用稿看起來通順,更要抽,因為錯藏在近音裡。校對優先序見 廣東話字幕校對。
常見問題
問:語言選中文,再全部取代成粵語口語,行不行? 答:助詞表可以處理一小部分,專有名詞與動詞猜錯無法用取代表還原。你沒有「國語近音 → 原句」的對照鍵。要出片,應先有粵語聽寫,再決定要不要轉書面語。
問:large-v3 選了粵語,為什麼稿仍像書面中文?
答:公開回報裡,強制 yue 仍可能輸出書面中文,自動偵測更常標 zh。代碼存在,不代表解碼器以口語漢字為預設。把輸出當草稿,用原音抽查動詞與專名。
問:Mac 上的 Whisper 應用沒有 yue 選項,是不是不能做廣東話?
答:許多套件只暴露「中文/自動」。那是介面限制,不是粵語不能轉寫。沒有 yue 時,你得到的多半是中文通道。要發布字幕,應改用可指定粵語、或專為廣東話訓練的流程,而不是在「中文」裡反覆重跑。
問:先出英文稿再翻譯成中文,會不會更穩? 答:粵語口播經英文再回中文,是兩次意譯。中英夾雜會被英文化一次、再中文化一次,品牌名與玩笑最容易沒有。口播是廣東話,就應先做廣東話聽寫。
問:會議紀要能不能繼續用 Whisper? 答:可以,只要你接受它是可搜的中文草稿,並人工鎖日期、人名、待辦。不要把同一份檔不經語體決定就掛上影片 CC。紀要與字幕是兩種密度,見 廣東話會議錄音轉文字。
本文由 CantoSub 團隊編寫;撰稿過程使用 AI 輔助,產品說明以官網為準。