校對完的廣東話對白,在文字編輯器裡看得一清二楚,匯入 Premiere 或上載 YouTube 卻變成問號、方塊、一串西歐字母——這就是廣東話字幕亂碼最常見的現場。很多人以為是粵語辨識失敗,回頭重轉一次音訊。多數情況不是聽錯了,而是字幕檔被用另一套字元編碼打開。
這類畫面特別容易出現在香港工作流:舊檔用 Big5 存、新檔用 UTF-8、Windows 記事本又多寫一個 BOM,再經過 CapCut 手機端、合作方的舊播放器來回傳。文字本身可能還在,只是讀檔方式錯了。若你已經把亂碼當正文改過一輪,那些位元組才真的救不回來。
讀完應能分清「看錯編碼」「檔案已被破壞」「只是字型不支援中文」三件事,並把一份可上架的 .srt 存成 UTF-8 再交給平台或剪輯軟件。格式本身怎麼選,見 SRT 與 FCPXML;本文只處理編碼。
廣東話字幕亂碼多半是編碼,不是辨識失敗
字幕檔是位元組。編碼告訴軟件:這串位元組對應哪些漢字。同一份繁體對白,用 UTF-8 存、用 Big5 讀,畫面就會碎。反過來,舊的 Big5 檔被預設當 UTF-8 打開,也會變成替換符或無意義符號。
這跟近音錯字不同。近音錯字讀得通、意思偏了,要對着原片改,見 廣東話字幕校對。亂碼是整句或整軌同時壞,專有名詞、標點、時間碼旁邊的文字一併不可讀。時間碼數字往往仍正常——因為阿拉伯數字在各編碼裡位置相近——於是有人以為「軸沒問題、只有中文壞了」,這其實是編碼問題的典型樣子。
先不要重跑語音轉文字。重跑浪費配額,也無法修好一份已經被錯誤另存過的檔。正確順序是:備份原檔 → 判斷壞法 → 用正確來源編碼重開 → 另存一份 UTF-8 → 在目標軟件再匯入一次。
YouTube 對 SubRip(.srt)寫明:檔案必須為純 UTF-8 編碼,且不吃樣式標記。官方說明見 YouTube:支援的字幕檔案。上載前把編碼修好,比在 Studio 裡反覆刪檔重傳省事。
先看畫面:三種壞法對應三種修法
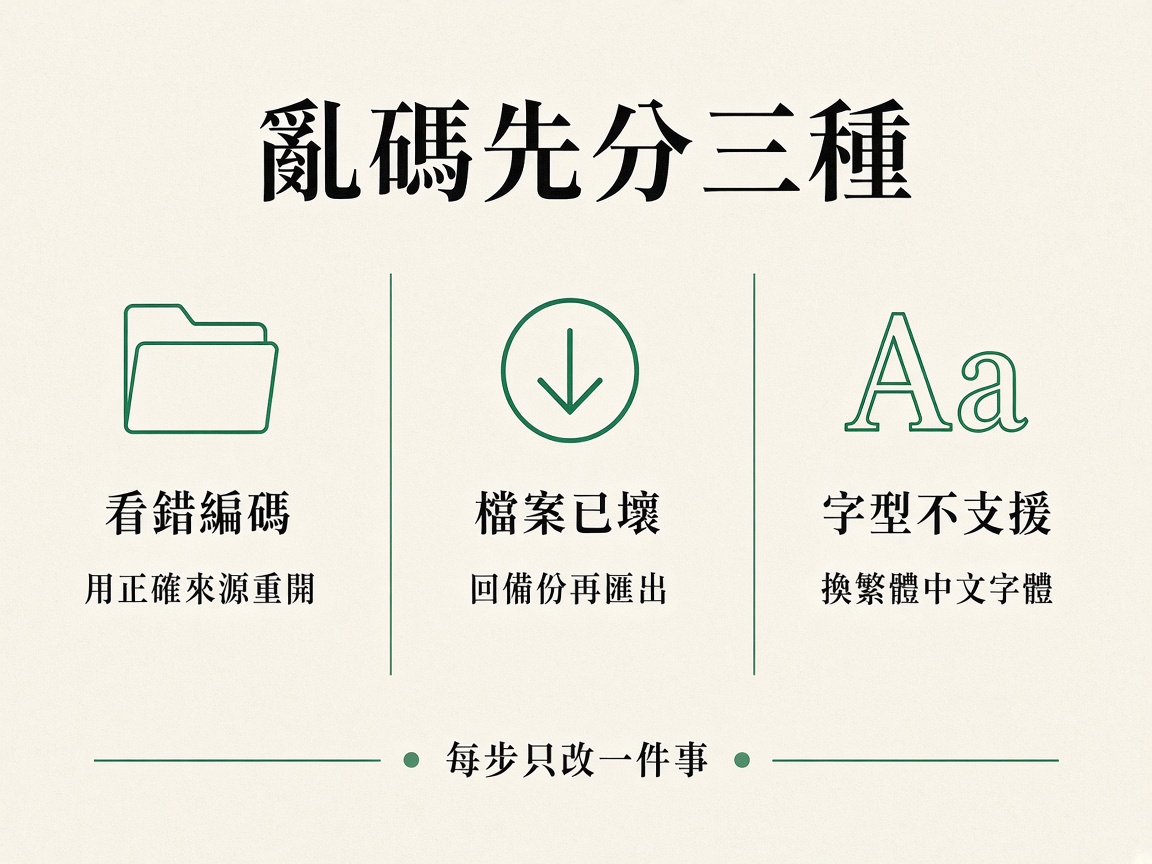
把螢幕上的「怪字」分成三類,修法才不會互相抵消。
一、看錯編碼(mojibake)。 漢字變成拉丁字母重音、標點變成 Ã 一類,或變成替換方塊,但檔案大小看起來正常。時間碼完整。這表示位元組多半還在,只是解碼表用錯。修法是「重開時聲明真正的來源編碼」,而不是在已經解錯的畫面上逐字重打。
二、檔案已被破壞。 問號 ? 已經寫進檔案、複製到別的編輯器仍然是問號,或中文位置變成等長的替換符且無法用任何編碼還原成可讀句子。這通常發生在:用錯誤編碼另存、用只懂英文的工具轉過一次、電郵系統把附件當純西歐文字處理。位元組丟了,只能回到更早的備份,或從仍正確的母帶重新匯出。
三、字型不支援。 編碼其實是 UTF-8,文字編輯器裡中文正常,剪輯時間軸上卻是星號或空心框。Premiere 等軟件若字幕軌用了不含中日韓字形的英文字體,就會畫不出字。這不是存檔問題,換「微軟正黑體、蘋方、思源黑體」一類字形即可。Adobe 社群亦有人遇到:記事本看來正常、匯入後變 *,複製貼上同一句卻正常——先查字型,再查編碼。
三類可以同時出現。例如 Big5 檔被當 UTF-8 讀(第一類),有人用記事本另存成「看起來整齊的問號」(變成第二類),再匯入時又選了英文字體(第三類)。所以每一步都只改一件事,並保留原檔。
香港常見:Big5、GBK 與 UTF-8 混用
香港舊電腦、舊燒錄流程、從論壇下載的影碟字幕,繁體中文很長一段時間用 Big5(Windows 上常叫 CP950)。內地簡體環境則多用 GBK/GB18030。現在的瀏覽器、YouTube、多數手機 App 預設 UTF-8。三種表不是同一套編號:用錯表,不是「繁簡轉換」,而是解出另一批字。
實務辨認:
- 預設當 UTF-8 打開後,繁體句子碎成替換符或西歐字母湯,優先試用 Big5 重開。
- 重開後出現「看起來像漢字、但用詞像簡體系統亂碼」或完全不通的近形字,再試 GB18030/GBK——常見於把內地同事的簡體 SRT 與香港繁體流程混在同一條時間軸。
- 編輯器裡已經是正常繁體,只在某一款舊播放器壞,先在該播放器手動指定 UTF-8,而不是把母帶改回 Big5。為遷就一台舊機頂盒而把全頻道字幕降回舊編碼,之後上 YouTube 又會再亂一次。
中英夾雜的字幕更要 UTF-8。deadline、SKU、歐文字母與漢字同句並存時,舊的單一位元組編碼沒有穩定位置放這些字。硬用 Big5 存夾雜稿,英文或標點可能先壞。夾雜用詞怎麼寫見 中英夾雜字幕;那是用字問題。編碼問題是:連正確的英文都會顯示成怪符號。
不要用「另存成 ANSI」當萬能鍵。在中文 Windows 上,ANSI 往往等於系統代碼頁(香港機可能是 Big5,另一台可能不是)。同一份檔在兩台電腦行為不同,合作時最容易互相指責「你那邊才亂」。統一 UTF-8,爭議才少。
記事本與 BOM:第一條字幕前面多了怪符號
UTF-8 本身不需要位元組順序標記(BOM)。部分 Windows 記事本「UTF-8」會在檔案開頭寫入三個位元組 EF BB BF。有的播放器會把這三個位元組畫成 ,緊貼在第一條字幕編號前面;有的解析器因此認不出第一條 cue,片頭十幾秒沒字,從第二句才開始。
若你看到:
- 只有第一句前面多了怪符號,後面中文正常;
- 或第一條時間碼解析失敗、其餘正常;
先懷疑 BOM,而不是懷疑整份編碼。用支援「UTF-8 無 BOM」的編輯器(例如新版記事本選 UTF-8、或 Notepad++ 轉成無 BOM 的 UTF-8)另存,再匯入。不要用「再存一次 UTF-8」循環疊加 BOM。
電郵、即時通訊傳 .srt 時,有的客戶端會當純文字預覽並改編碼。較穩的做法是壓縮成 .zip 再傳,或直接在雲端硬碟傳原檔。收到對方檔先在本機用十六進位或編碼選單確認,不要先在手機備忘錄打開再複製回來——那一步最容易把 UTF-8 變成系統預設頁。
匯入 Premiere、CapCut、YouTube 時分別查什麼
同一份檔,三個出口的失敗訊號不同。不要用同一句「轉碼」應付。
YouTube Studio。 上載字幕後預覽若整軌問號,先確認副檔名是 .srt、沒有包 HTML、時間碼用逗號毫秒。官方要求純 UTF-8。預覽正常但公開頁沒有字幕,那是語言標籤、發布狀態或自動字幕覆蓋的問題,不是本文範圍;上載步驟見 YouTube 廣東話字幕。
Premiere Pro。 先在記事本或 VS Code 確認中文可讀,再匯入。若編輯器正常、時間軸星號,改字幕軌字型為含繁體字形的字體,並檢查字幕樣式有沒有強制英文字族。若編輯器已經亂,不要在 Premiere 裡改字——那裡改的是解錯之後的字,存回去會把錯誤寫死。Premiere 內建轉寫與匯入 SRT 是兩條路,見 Premiere Pro 廣東話字幕。
CapCut。 手機端與桌面端對檔案編碼的容忍度不一定相同。手機相簿「打開字幕檔」有時會經系統分享列轉碼。較穩是從電腦匯出 UTF-8 SRT,用官方匯入字幕,而不是把檔案當聊天附件傳來傳去。CapCut 自動辨識與匯入校對稿的分工見 CapCut 廣東話字幕。
VLC 或舊 Windows Media Player。 播放器可以在選單指定字幕編碼。能在 VLC 用 UTF-8 播對,不代表檔案不是 UTF-8——只代表這台播放器預設猜錯。交付給客戶時,仍應給 UTF-8,並在說明寫「請用 UTF-8」;不要為了對方預設值把母帶改成 Big5。
燒錄進畫面的字不再依賴播放器編碼,但燒錄前那一版稿仍要是正確 UTF-8,否則燒進去的就是怪字。軟字幕與燒錄怎麼分,見 軟字幕與燒錄字幕。
字型方塊與編碼亂碼不要一次改
趕工時最常見的疊加錯誤:匯入後看到框,立刻「另存新編碼」,再換字型,再重上 YouTube。每一步都改了檔案,最後無法知道哪一步才有效,也無法回退。
建議固定四步,每步只驗證一件事:
- 備份。 複製一份
檔名-original.srt,之後只動工作副本。 - 在純文字編輯器裡讀對。 需要時用「以編碼重新打開」試 Big5、GB18030、UTF-8。讀對之後,另存 UTF-8(無 BOM)。此步成功的定義是:專有名詞、數字、標點在編輯器裡與你記憶中的校對稿一致。
- 在剪輯軟件換中文字型。 只有當第 2 步已正常,時間軸仍出框,才換字型。不要在第 2 步失敗時換字型。
- 在目標平台預覽。 YouTube 用 Studio 預覽;長片再對一次公開頁。短片若燒錄,在成片靜音播一次,確認沒有把怪字燒進去。
若第 2 步無論用哪種來源編碼都讀不對,停止轉碼。回去生成端重新匯出,或回去你上次可讀的雲端版本。把已經是問號的檔反覆「轉換」,只會讓檔案更不可逆。
預防:母帶只存一份 UTF-8 SRT
亂碼很少發生在「剛剛從現代工具匯出、從未用記事本另存」的檔。它發生在版本疊代:A 用 Mac 另存、B 用舊記事本、C 用簡體系統打開再傳回來。頻道應規定:
- 母帶只有一份,檔名帶日期,編碼 UTF-8 無 BOM。
- 剪輯專案、YouTube、短片燒錄都從這份衍生,不要三個人各改各的副本再合併。
- 合作方要改字,請他們在仍顯示正確中文的編輯器改,交回後你再對一次專有名詞——編碼對了,用字仍可能被改錯。
- 舊影碟、舊活動的 Big5 字幕若仍要重用,先轉成 UTF-8 歸檔,不要讓 Big5 繼續在資料夾裡和新檔並排,下次一定會開錯。
需要由廣東話音訊產出可校對的 .srt 時,可用 CantoSub 出稿;能力見 Model 2.0,用量見 收費。匯出之後仍要用上述四步確認檔案在你的剪輯軟件與 YouTube 預覽裡是可讀繁體,而不是假設副檔名是 .srt 就一定不會亂。
常見問題
問:在手機備忘錄裡中文正常,電腦上卻亂,是哪邊壞? 答:兩邊用了不同預設編碼,或傳檔過程被轉成純文字。以電腦上的原檔為準,用編碼選單重開;不要從備忘錄複製回檔案。傳檔用壓縮包較穩。
問:轉成 UTF-8 之後,舊電視盒反而更亂,要不要改回 Big5? 答:那是播放器預設值問題。可為該裝置另出一份指定編碼的交付檔,但頻道母帶應維持 UTF-8,否則 YouTube 與現代剪輯軟件會再出問題。
問:FCPXML 也會亂碼嗎?
答:FCPXML 是 XML,現代匯出多為 UTF-8。亂碼仍較常出現在純文字 .srt 被記事本、電郵、舊播放器改寫之後。Final Cut 深修用 FCPXML 的取捨見 SRT 與 FCPXML。
問:把亂碼句子逐字重打,能不能當修好? 答:若你是對着正確的聲音重打,等於放棄原檔重做字幕,可行但慢。若你是看着已經解錯的字去「猜」正字,會把錯誤寫死,以後任何編碼都救不回。先重開,再考慮重打。
問:簡體 GBK 檔直接當繁體用可以嗎? 答:不行。那是另一張代碼頁,不是繁簡轉換。要給香港觀眾看,應在文字正確解碼之後,再決定是否另行譯寫用語,而不是靠改編碼「變繁體」。
本文由 CantoSub 團隊編寫/審閱;撰稿過程使用 AI 輔助,事實與產品說明以官網為準。YouTube 檔案要求以 Google 說明中心為準。