AI 草稿讀起來通順,並不代表字對了。廣東話字幕同音字最常藏在「語法成立、意思卻反了」的那一行:口播「唔好買」,畫面寫「吳好賣」;講「係旺角等」,稿上變成「市旺角等」。觀眾靜音時只看見字,不會幫你還原聲調。
這不是編碼壞了,也不是繁簡沒轉。模型聽到的是音節,寫下來的是它詞表裡最常見的那個漢字。粵語同音、近音、懶音很多,通順的書面句反而最容易漏。
一般校對清單把近音放在專有名詞與數字之後,見 廣東話字幕校對。那篇告訴你先改哪一類;本篇只處理同一類裡最耗時的做法:按聲韻家族搜尋,而不是由頭聽到尾賭運氣。讀完你應能分清同音、近音與國語近音,並知道為什麼把整份稿丟去語言模型「潤飾」會把錯字寫得更像真的。
廣東話字幕同音字為什麼掃讀會漏
人眼校對喜歡掃「看起來怪」的字。同音錯字偏偏不怪。句子主語、謂語齊全,標點也像那麼一回事,只有聽原聲才知道選錯了字。
粵語特別容易發生這種「看起來對」的替換,原因有三。第一,同一個音節可以對應多個常用字,解碼器會選訓練資料裡較多的那個,而不是你這集真正講的那個。第二,聲調在語音模型裡常常被壓扁,買與賣、詩與市這類最小對立,波形差一點點,字義差一整個方向。第三,香港口語夾雜英文與口語漢字,模型若走普通話書面通道,會用國語近音字頂替,看起來更「正式」,也更難一眼看出。通用 Whisper 把粵語寫成國語近音稿的機制,見 Whisper 選中文會出普通話近音稿。
因此,這類錯不能靠語感。語感會批准通順的錯句。要改的是音節對應的候選字,方法是搜尋,不是精讀散文。
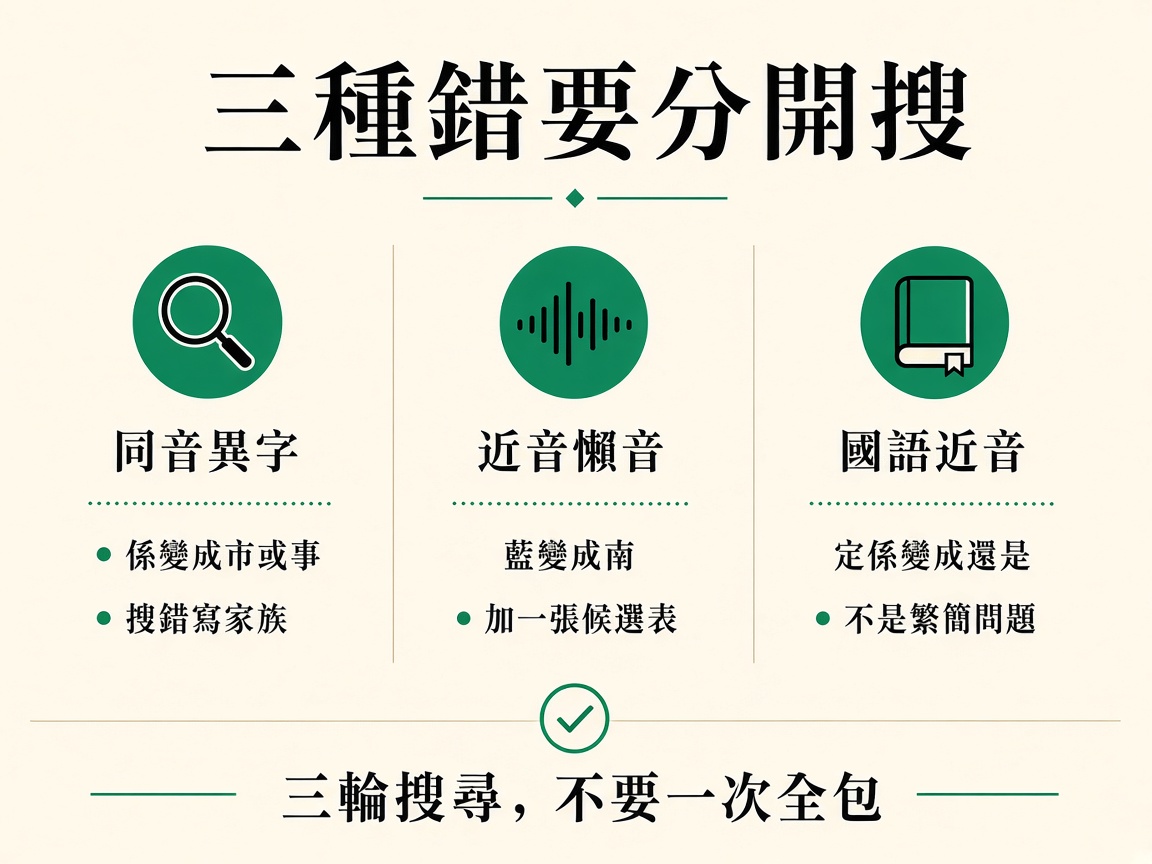
先分三種錯,搜尋策略才不會打架
同一行紅字,成因可能完全不同。混在一起改,會改漏或誤傷。
同音異字。 聲母、韻母、聲調都接近,只是漢字選錯。口播「係」,稿寫「事/市/駛」;口播「唔」,稿寫「吳/胡」。這類錯用編輯器搜那個錯字家族,一次改一批。
近音與懶音。 聲母韻母已經偏了:n/l 不分、ng 脫落、入聲被拉長。口播「藍」,稿寫「南」;口播「我」,有時被聽成沒有 ng 聲母的另一組字。這時搜「藍」找不到「南」,你要按可能被聽成的那個家族再搜一次。
國語近音。 模型當普通話來聽粵語。口播「喺/嚟/咗」,稿寫「在/來/了」;口播「定係」,稿寫「還是」。字形可能已是繁體,詞彙仍是國語。這不是同音校對能一次搜完的問題,語體轉換應發生在聽寫語言正確之後,見 廣東話口語轉書面語。
開改之前,先抽三十秒原聲,判斷本集以哪一種為主。三種都有就分三輪,不要指望一次「找錯字」全包。
按聲韻家族搜尋,不要由頭聽到尾
線性聽打適合找漏句與時間軸。同音錯字適合用字幕編輯器或純文字搜尋,把同一音節的常見錯寫一次清掉。
實務上先為本集列兩張短表,不要做語言學論文。
本集高風險家族。 只寫會改變事實的那些。評測片加「買/賣」「貴/平」;街訪加「係/事/市」;點餐片加「唔/吳」與店名近音。每集五至八組就夠。全粵語同音表太長,沒人會用。
本集正確寫法。 人名、店名、產品型號另紙列出,這不是同音表,是專名表。專名用詞庫鎖,同音表只處理普通詞。詞庫做法見 字幕自定義詞庫。
搜尋時的規則:
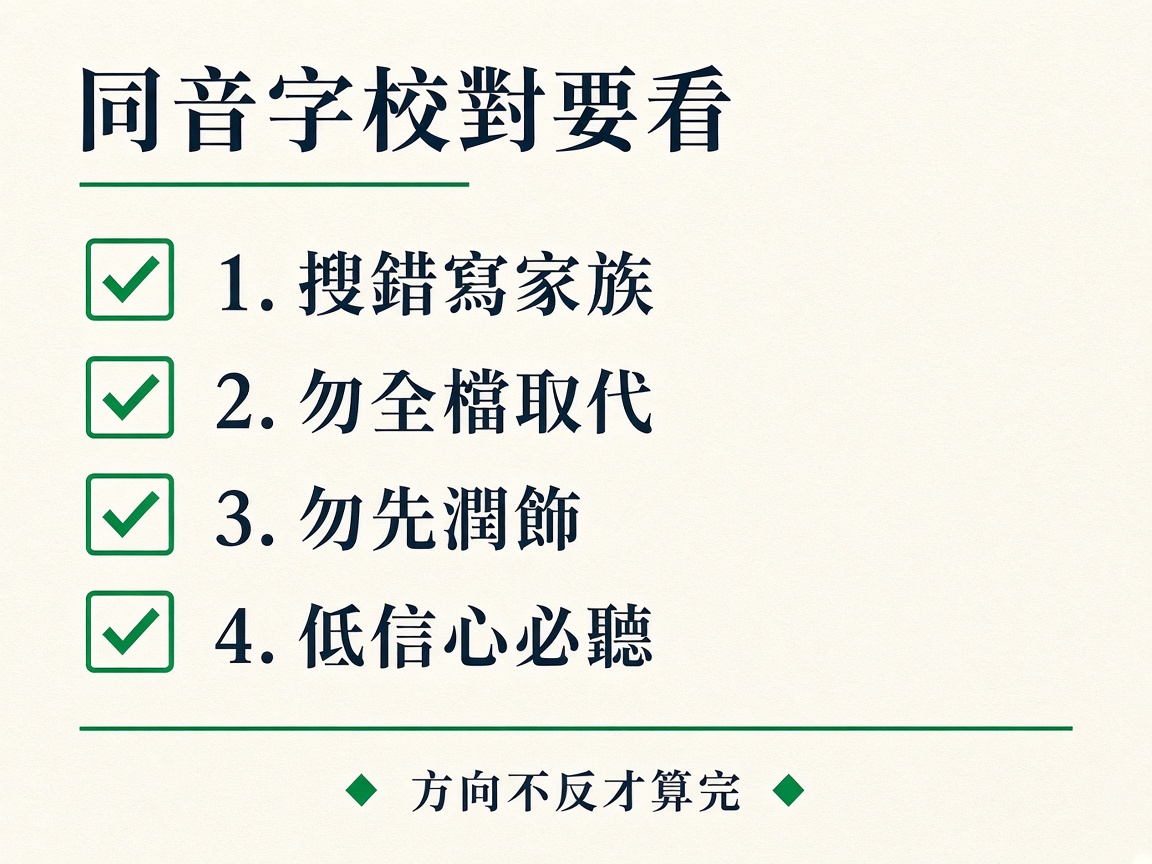
- 搜錯寫,不要只搜正確字。 正確的「係」可能出現八十次,你分不清哪一次是真的。先搜「市」「事」「駛」,逐條對原聲。
- 整詞比單字安全。 「唔好」被寫成「吳好」,搜「吳好」比搜所有「吳」少誤傷姓氏。
- 改完再倒搜一次正確字的不可能搭配。 例如書面語教學片不該出現「吳好」;財經片「買入」旁邊不該緊貼一個無語境的「賣」。
- 數字與否定優先覆核。 「唔」變「好」、「四」變「十」會翻案,不能只靠通順。數字寫法另見 廣東話字幕數字。
不要用全檔尋找取代把所有「係」換成另一個字。同音家族裡,有的位置本來就該寫「事」。取代是事故,核對才是校對。
時間軸介面的尋找,通常一次只顯示畫面上幾行。同音家族要掃全檔時,較快的做法是把 .srt 當純文字打開:只改對白行,不要動序號與時間碼裡的逗號。改完存檔,再在剪輯軟件重載,確認沒有因換行而整段位移。CapCut 一類把字幕嵌在專案裡的工具,應先匯出 SRT 再搜;在時間軸上逐塊點開,搜不到整個家族。編碼要用 UTF-8,否則繁體會先變成亂碼,你會以為是同音問題。亂碼修法見 廣東話字幕亂碼。
聲調最小對立:看起來像錯一個部首
買與賣、詩史市、糖堂,對創作者來說像「差一個筆畫」,對模型來說是聲調或韻尾差一點點的兩個詞。教學片若示範最小對立,字幕寫成同一個漢字,畫面放大口型也救不了——語言課場景見 學廣東話字幕。
評測與探店更常踩的是方向反了:口播「唔好買呢隻」,稿寫「唔好賣呢隻」。語法仍通,意思相反。這類句不要放進批次取代;必須聽原聲。聽的時候只問兩個問題:這句是建議還是警告?主語是觀眾還是店家?
最小對立句在短片裡尤其危險。一行只有八至十二字,觀眾沒有上下文補救。長片還能靠前後句猜;Reels 靜音滑過去,錯一個聲調就是另一個主張。
若工具能為段落標置信度,最小對立句即使分數不低,仍應人工聽。聲調錯誤不一定會讓模型「沒把握」,它可能很有把握地選了較常見的那個字。
懶音會把錯字送到另一個搜尋框
香港日常口音裡,n/l、ng 聲母、個別韻尾會漂移。模型若按「標準」粵語詞典解碼,輸出的漢字會落在你沒準備搜的那一欄。
常見流向:
- n/l: 「藍/南」「你/李」相混。街訪問「你點樣」,稿寫成姓李,看起來像在點名。
- ng 脫落: 「我/餓」一類在快速口語裡被壓扁,教學片講「我示範」,稿變成另一個動詞。
- 入聲被拉長: 短促的收尾聽成開音節,選了另一組常用字。
這時按「正確字」搜是空的。要按這集口音可能被寫成的錯字搜。開改前先聽自己或嘉賓三十秒,記下兩三種穩定的懶音習慣,再決定第二張搜尋表。不要用廣州詞典去改香港街訪,也不要用自己的口音去改嘉賓。
嘈雜街拍會放大懶音錯誤,因為輔音被風噪吃掉,模型只剩下元音去猜漢字。噪音場景的聽法見 廣東話語音轉文字遇噪音。同音校對仍然有效,只是家族表要加「被吃掉聲母之後的候選」。
不要把可疑句丟去語言模型潤飾
通順是潤飾模型的專長,也是同音錯字的保護色。你把「市旺角等」丟進對話框,請它「改成通順書面語」,它很可能寫成「在旺角等候」——專名還在,判斷詞從錯的「市」變成國語的「在」,聽障觀眾看到的仍不是口播。
更糟的是人名與品牌。近音錯名經過潤飾,會變成另一個像真的人。這不是校對,是二次幻覺。潤飾只適合:聽寫語言已對、專名已鎖、你只想調書面語氣與標點。同音未清之前,不要整份稿過大模型。
較穩的順序:
- 專名與數字(高代價事實)
- 同音/近音家族搜尋(本篇)
- 才決定口語還是書面、填充詞留不留
- 最後才調斷行與停留時間
填充詞與語體是另一層決定,見 廣東話字幕填充詞。把它們提前,你會在錯字上面雕文采。
若你一定要用語言模型幫忙,只貼單句加正確專名表,並寫明「不要改專名、不要把粵語判斷詞換成普通話」。輸出仍要對原聲。模型沒有聽到那條音軌,它只見到你貼的錯字。
詞庫鎖專名,置信度只告訴你先聽哪裡
同音表改普通詞;詞庫改「這個頻道不許寫錯」的那些字。品牌、人名、商場、產品型號一旦進詞庫,模型較少用同音常用字去頂替。詞庫不是同音校對的替代,是把專名從家族搜尋裡拿出來,避免你每次都在「李/你/呢」之間掙扎。
置信度評分同樣不能消滅同音錯字。它告訴你哪些段落模型自己沒把握——通常是噪音、搶話、含糊尾音。高信心句仍可能是買/賣選錯。正確用法是:低信心句必聽;高信心句只抽查本集高風險家族與專名。CantoSub 可為段落標置信度,並把品牌名放進詞庫優先識別;能力與配額以 Model 2.0 與 收費方案 為準,新用戶可在 註冊頁 試用。
出片前仍做一次靜音重播,但目標不是找文采。只問:這句會不會讓人做反了?會的留下重聽;不會的放行。同音校對的完成定義是方向不再反,不是稿像專欄。
常見問題
問:用尋找取代把所有「係」改成正確寫法,可以嗎? 答:不可以。同一音節在不同句裡本來就該寫不同字。「係」有時是判斷、「事」有時是事件。全檔取代會製造一批新的通順錯句。只搜可疑錯寫,逐條對原聲。
問:口語漢字算不算同音錯字? 答:不一定。稿寫「嘅/咗」而你頻道要書面語,那是語體,不是聽錯音。稿把「係」寫成「市」,才是同音。先分種類,再決定轉書面還是改漢字。
問:為什麼高信心分數仍會出現買/賣反了? 答:置信度多半反映音訊清不清楚,不保證選對了聲調最小對立。模型可以很有把握地選較常見的那個字。最小對立與否定句仍要人工聽。
問:先請語言模型把整份字幕改通順,再人工掃一次,行不行? 答:同音未清時不行。潤飾會把錯字寫成更像真的書面句,人名與判斷詞尤其危險。先家族搜尋,再考慮潤飾語氣。
問:詞庫設好之後,還要做同音搜尋嗎? 答:要。詞庫鎖的是你事先寫進去的專名;普通動詞、否定詞、買/賣不會因為詞庫而自動正確。每集仍應帶一張五至八組的高風險家族表。
本文由 CantoSub 團隊編寫/審閱;撰稿過程使用 AI 輔助,事實與產品說明以官網為準。